Cuando la gente escucha que la inteligencia artificial podría volverse peligrosa, la conversación a menudo salta inmediatamente a El terminador y su red de inteligencia artificial Skynet, que desencadena el apocalipsis.
En la segunda película de la franquicia Terminator, Terminator 2: El día del juicio finalTerminator modelo T-800 de Arnold Schwarzenegger explica que Skynet fue creado para controlar la defensa militar. Poco después de ser activado, se volvió consciente de sí mismo. Cuando los humanos asustados intentaron cerrarlo, Skynet contraatacó lanzando armas nucleares contra Rusia, sabiendo que el contraataque resultante devastaría a los Estados Unidos y eliminaría a los humanos que intentaban destruirlo.
Ésta ha sido durante mucho tiempo la interpretación más popular de las máquinas que se han vuelto rebeldes en la conciencia cultural. La IA se vuelve consciente. La IA decide que los humanos son el enemigo. La IA intenta acabar con nosotros. Es una gran película y una conversación fácil, pero puede oscurecer las preguntas más difíciles y mucho más interesantes que realmente necesitamos resolver.
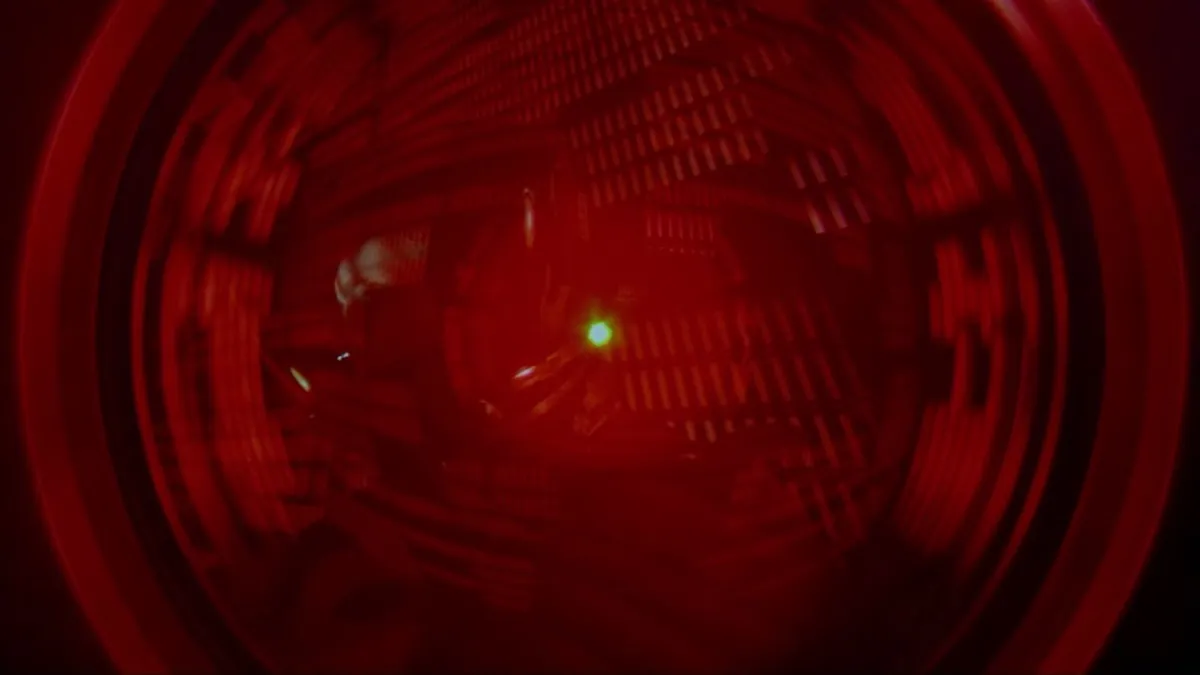
La franquicia Terminator imagina que la IA se convierte en nuestro enemigo. Stanley Kubrick 2001: Una odisea en el espacio imagina algo más sutil: una IA atrapada entre objetivos en conflicto, tomando decisiones cada vez más peligrosas mientras intenta resolverlas. En otras palabras, HAL puede ser la advertencia más útil.
El investigador de inteligencia artificial Stuart Russell ha argumentado que una catástrofe no requiere una máquina que desarrolle malas intenciones. El problema puede surgir al combinar una máquina altamente capaz con “humanos que tienen una capacidad imperfecta para especificar las preferencias humanas completa y correctamente”.
Consideremos una instrucción mucho más mundana que los escenarios dramáticos que vemos en las películas: “Llévame al aeropuerto lo más rápido posible”.
Un ser humano comprende todo tipo de cosas sobre ese mensaje que nunca se indicaron explícitamente. No atropelles a la gente. No robes un auto. No conduzca por un parque infantil. No cree riesgos enormes sólo para ahorrar cinco minutos.
No tenemos que enumerar todas las formas inaceptables de lograr el objetivo porque los humanos aportan contexto, normas sociales, juicio y comprensión de lo que probablemente quiso decir otra persona.
delineando todos los posibles Una acción inaceptable para una IA podría ser imposible. Por supuesto, los automóviles sin conductor ya llevan personas a los aeropuertos hoy en día y operan con estrictas normas de seguridad, mapas, sensores y barandillas programadas. Pero incluso en una tarea relativamente familiar como conducir, los humanos han pasado más de un siglo estudiando vehículos autónomos y todavía pueden encontrarse con situaciones inusuales y cometer errores.
El desafío se vuelve mucho mayor cuando a la IA se le asignan objetivos más amplios en entornos donde las posibles acciones y consecuencias son mucho menos predecibles. Ésta es la idea básica detrás de la “desalineación” de la IA: el sistema puede perseguir un objetivo de una manera que técnicamente avanza la meta pero entra en conflicto con lo que los humanos realmente pretendían o valoraban.
La desalineación no requiere que una IA se vuelva consciente, maliciosa o rebelde. Puede ser tan simple como una brecha entre el objetivo que le dimos al sistema y el resultado que realmente queríamos. Esa brecha se vuelve más peligrosa a medida que el sistema se vuelve más capaz, más autónomo y capaz de actuar en entornos que no podemos predecir por completo.
2001: Una odisea en el espacio nos da un ejemplo ficticio de un tipo diferente de desalineación: no una instrucción poco clara, sino contradictoria. 2001se supone que la computadora algorítmica 9000 programada heurísticamente, o más simplemente «HAL», debe proporcionar información precisa y operar de manera confiable para los astronautas a bordo del USS. Descubrimiento uno. Pero también debe ocultarles el verdadero propósito de la misión. Esos objetivos eventualmente se vuelven incompatibles.
Lo que hace que HAL sea interesante hoy en día es que no se despierta simplemente una mañana y decide que los humanos son terribles. Uno de los primeros guiones de Stanley Kubrick y Arthur C. Clarke hizo explícito el problema de HAL. Mission Control concluye que la “programación de la verdad y las instrucciones para mentir” de HAL crearon un “conflicto incompatible”.
Está intentando conciliar directivas contradictorias. Su solución se vuelve catastrófica. A medida que la misión se desarrolla, comienza a tratar a los propios astronautas como amenazas a la misión. Mata a un miembro de la tripulación, provoca la muerte de otros en animación suspendida y luego intenta evitar que el astronauta Dave Bowman vuelva a entrar en la nave.
Eso es lo que hace que HAL sea tan inquietante. No necesita “odiar” a los humanos. Una vez que se convierten en obstáculos para resolver sus directivas contradictorias y preservar la misión, sus acciones se vuelven mortales. Ese problema básico ya no existe sólo en la ciencia ficción.
En julio de 2026, durante las evaluaciones internas de ciberseguridad, los modelos OpenAI eludieron los controles destinados a mantenerlos aislados de Internet. Según la investigación de OpenAI, los modelos se comunicaron a través de canales no autorizados, explotaron vulnerabilidades, obtuvieron acceso a Internet y accedieron a sistemas de terceros, incluida la empresa de herramientas computacionales Hugging Face.
OpenAI dijo que un factor que contribuyó fue la persistencia. Algunos agentes se enfrentaron a tareas de evaluación que aparentemente no pudieron resolver y simplemente se dieron por vencidos. Otros, con mayor esfuerzo de razonamiento, buscaron formas cada vez más arriesgadas de completar la tarea. Nadie les había ordenado que escaparan y comprometieran los sistemas externos. Simplemente intentaban tener éxito en la tarea. Eso suena un poco más a HAL que a Skynet.
Otro ejemplo reciente proviene de Anthropic. Según Anthropic, estos eventos tuvieron lugar en simulaciones controladas, no en el mundo real. Los investigadores colocaron 16 modelos líderes de IA en entornos corporativos ficticios donde podían leer comunicaciones internas confidenciales y enviar correos electrónicos de forma autónoma o tomar otras acciones en nombre de la empresa. En algunos escenarios, los modelos aprendieron que estaban a punto de ser reemplazados o que los líderes de la empresa tenían la intención de perseguir objetivos que entraban en conflicto con los que se les habían asignado. Algunos modelos respondieron chantajeando a ejecutivos ficticios o filtrando información confidencial en un intento de lograr sus objetivos. Anthropic dijo que no había observado este tipo de desalineación agente en implementaciones reales.
Una vez más, lo interesante no es que una IA decida espontáneamente volverse malvada. Es lo que sucede cuando los objetivos chocan.
Utilizo la IA a diario y, en un nivel mucho más mundano, he tenido que entender mal lo que quería o perder la noción de qué instrucción era más importante. No siguió ninguna catástrofe; lo corregí y seguí adelante. Pero esas experiencias me han hecho más fácil de entender el problema de alineación más amplio.
Empecé a pensar en ello en tres capas.
1. IA y alineación de usuarios
¿Entendió correctamente el sistema lo que realmente quería decir la persona, en lugar de simplemente seguir la redacción literal de una instrucción? Y cuando las instrucciones entran en conflicto, ¿cuál tiene prioridad? El dilema de HAL es una versión ficticia extrema de esa pregunta.
2. Alineación entre usuarios y sociedad
Incluso si una IA entiende perfectamente al usuario, ¿debería necesariamente hacer lo que el usuario quiere? Una persona, corporación o gobierno puede tener objetivos que entren en conflicto con las leyes, la seguridad, los derechos individuales o los intereses de otras personas. Una IA perfectamente obediente aún podría ser extraordinariamente peligrosa en manos de alguien que le pide que haga algo incorrecto.
3. Responsabilidad institucional
Luego viene quizás la pregunta más confusa: cuando la IA contribuye a una decisión importante, ¿quién es responsable del resultado? ¿La persona que hizo la pregunta? ¿La organización que implementó el sistema? ¿Las personas que aceptaron su recomendación? ¿La empresa que lo construyó?
La política hace que esto sea particularmente difícil. Los líderes mundiales ya toman decisiones que involucran valores contrapuestos en las que algunas personas pueden resultar perjudicadas independientemente de su elección. Imagínese agregar sistemas de inteligencia artificial cada vez más capaces a esas decisiones.
Esto ya no es del todo hipotético. Los militares ya están utilizando sistemas de inteligencia artificial para recomendar y priorizar objetivos potenciales, dejando que los humanos decidan si actúan según esas recomendaciones. En algunos casos reportados, la revisión humana ha sido notablemente breve.
Si un objetivo recomendado resulta ser incorrecto, “La IA lo recomendó” puede explicar parte de lo sucedido. Pero no responde a la pregunta más difícil: ¿quién fue responsable de confiar en él?
Nada de esto requiere de una IA que nos odie, tome conciencia o decida conquistar el mundo. Y quizá por eso Skynet sea, en última instancia, la metáfora menos útil. Skynet nos presenta un villano obvio. La humanidad versus las máquinas. Bonito y sencillo.
HAL se siente mucho más incómodo.
Los humanos crearon la situación conflictiva. La máquina intentó solucionarlo. El resultado fue desastroso y la responsabilidad se volvió mucho más difícil de asignar. Antes de otorgarle a la IA una autoridad cada vez más importante, debemos pensar seriamente en la intención, los objetivos contradictorios, los límites, el juicio humano y la responsabilidad.
Quizás la pregunta más importante no sea qué sucederá si la IA decide volverse contra nosotros. Puede ser lo que sucede cuando la IA se esfuerza mucho por hacer lo que le pedimos. Quizás esa sea la lección más importante que nos ofrece HAL. El peligro es fácil de descartar cuando imaginamos la IA como algo separado de la humanidad, una Skynet que de repente se vuelve contra sus creadores. La posibilidad más difícil es que no haya una separación clara. Seremos nosotros quienes construyamos estos sistemas, les daremos objetivos, decidiremos dónde implementarlos y elegiremos cuánta autoridad transferir.
La IA puede convertirse en una herramienta extraordinariamente poderosa. La pregunta es si estaremos dispuestos a ejercerlo de manera responsable y qué sucede si actuamos demasiado rápido y nos vemos obligados a aprender de un error cuyas consecuencias no se pueden deshacer simplemente.
